WeVisOne-VL: AI Vision Tencent untuk Deteksi, OCR, Segmentasi 2026
Tencent merilis WeVisOne-VL, model vision-language yang menggabungkan deteksi objek, counting, OCR, segmentasi, dan matting dalam satu model — plus kemampuan langka: berani menjawab 'tidak ada' saat objeknya memang tidak ada di gambar.
Tencent resmi memperkenalkan WeVisOne-VL, model vision-language terbaru yang dirancang untuk melihat gambar dengan presisi tinggi. Model ini hadir dalam dua ukuran, 2B dan 4B, dengan paper yang diajukan pada 22 Oktober 2026. Yang membuatnya menarik bukan sekadar ukurannya, melainkan ambisinya: satu model yang mengerjakan lima tugas persepsi sekaligus, tugas-tugas yang selama ini biasanya ditangani oleh model-model terpisah.
Apa itu WeVisOne-VL?
WeVisOne-VL adalah vision-language model, jenis model AI yang memahami gambar sekaligus teks. Pengguna bisa menunjukkan gambar dan bertanya dalam bahasa natural, lalu model menjawab berdasarkan apa yang ia lihat. Bedanya dengan model vision biasa, WeVisOne-VL tidak hanya menjawab "apa yang ada di gambar" secara umum, tetapi juga bisa menunjuk dengan presisi: di mana tepatnya suatu objek berada, ada berapa jumlahnya, teks apa yang tertulis, dan bagian mana yang termasuk objek versus latar.
Dua ukuran yang dirilis — 2B dan 4B — memberi pilihan: versi yang lebih kecil untuk perangkat dan aplikasi yang butuh kecepatan, serta versi yang lebih besar untuk tugas yang menuntut ketelitian lebih tinggi.
Lima tugas dalam satu model
Selama ini, alur kerja vision AI sering seperti estafet. Satu model mendeteksi objek, hasilnya dilempar ke model lain untuk membaca teks, lalu ke model lain lagi untuk memisahkan objek dari latar. Setiap sambungan menambah kompleksitas dan peluang salah. WeVisOne-VL mencoba memangkas rantai itu dengan menangani lima kemampuan sekaligus:
Deteksi objek. Model menggambar kotak pembatas di sekeliling objek yang diminta, misalnya menemukan semua mobil dalam foto jalan raya.
Counting. Model menghitung jumlah objek, misalnya berapa orang dalam kerumunan atau berapa produk di rak toko.
OCR. Model membaca teks yang ada di dalam gambar, dari rambu jalan hingga isi dokumen yang difoto.
Segmentasi. Model memisahkan objek dari latarnya piksel demi piksel, bukan sekadar kotak kasar. Ini penting untuk editing gambar dan analisis medis maupun industri.
Matting. Ini versi segmentasi yang lebih halus: memisahkan detail rumit seperti rambut atau objek transparan dari latarnya, kemampuan yang biasanya hanya dimiliki alat editing khusus.
Menggabungkan kelimanya dalam satu model berarti pengembang tidak perlu merangkai banyak model, dan pengguna mendapat jawaban yang konsisten dari satu sumber.
Contoh konkretnya mudah dibayangkan. Sebuah aplikasi arsip bisa memotret dokumen, membaca seluruh teksnya lewat OCR, sekaligus menandai posisi tanda tangan dan stempel lewat deteksi dan segmentasi — semuanya dari satu model yang sama. Atau kamera toko yang menghitung pengunjung, mengenali produk yang mereka pegang, dan membaca label harga dalam satu proses. Inilah efisiensi yang dijanjikan pendekatan satu model.
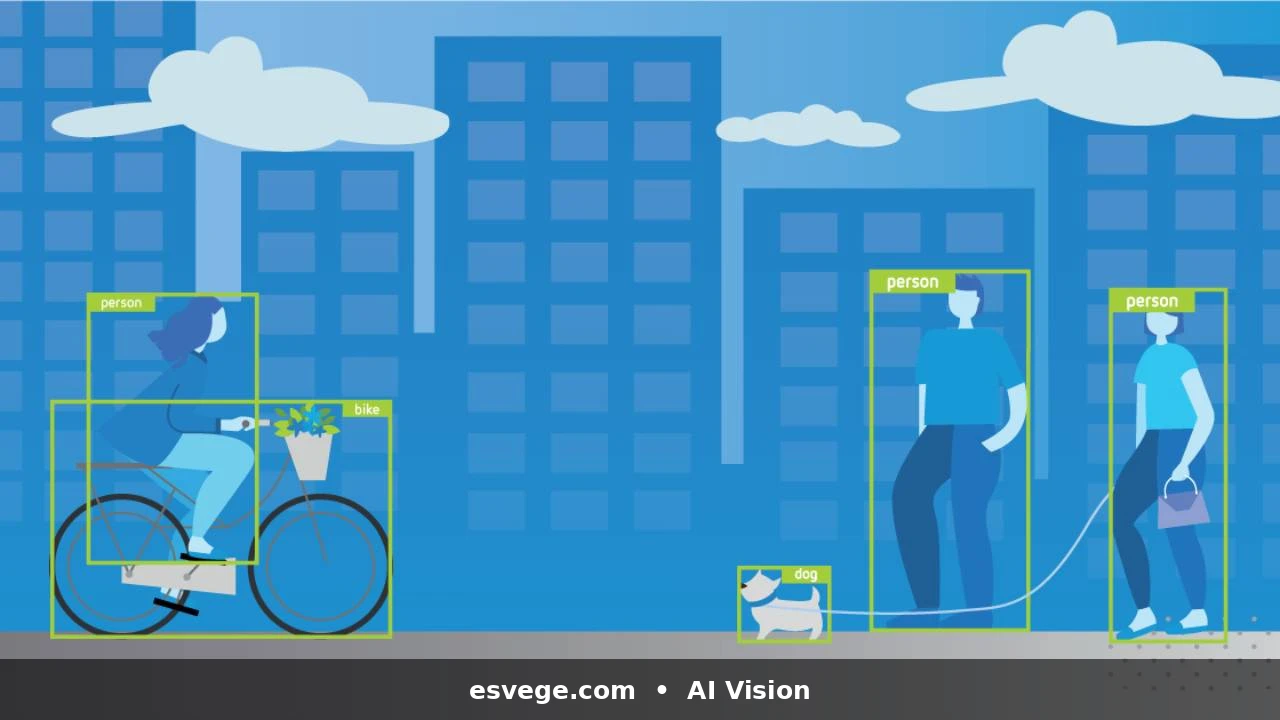
Ilustrasi deteksi objek — Kajabi.
Fitur paling penting: berani bilang "tidak ada"
Satu kemampuan WeVisOne-VL yang patut mendapat sorotan adalah jawaban eksplisit untuk objek yang tidak ada. Banyak model vision dilatih untuk selalu mengembalikan lokasi begitu ditanya "di mana X?", sehingga ketika X sebenarnya tidak ada di gambar, model tetap menunjuk sesuatu — jawaban yang meyakinkan tapi salah. Inilah salah satu bentuk halusinasi visual.
WeVisOne-VL mendukung respons absent-object secara eksplisit: ia bisa menyatakan bahwa objek yang dicari memang tidak ada di gambar, alih-alih memaksakan lokasi. Kedengarannya sepele, tetapi dampaknya besar. Dalam pemahaman dokumen, pemeriksaan industri, atau bantuan robotik, jawaban salah yang percaya diri jauh lebih berbahaya daripada jawaban "tidak ada". Model yang tahu batasnya sendiri adalah model yang lebih bisa dipercaya.
Kenapa ini penting
WeVisOne-VL menandai pergeseran yang lebih luas di dunia AI vision: dari kumpulan model spesialis menuju satu model generalis persepsi. Bagi pengembang, ini menyederhanakan arsitektur aplikasi. Bagi pengguna akhir, ini membuka alat yang lebih andal untuk pekerjaan yang membutuhkan teks dokumen sekaligus lokasi yang presisi — misalnya menganalisis formulir yang difoto, memeriksa kelengkapan produk di rak, atau membantu penyandang tunanetra memahami isi gambar secara detail.
Tentu saja, seperti semua rilis penelitian, WeVisOne-VL masih perlu pembuktian di pemakaian nyata dan pengujian independen. Namun pendekatannya sudah menunjukkan arah yang jelas: model vision masa depan tidak hanya harus pintar melihat, tetapi juga jujur tentang apa yang tidak dilihatnya. Satu model, lima tugas, plus keberanian untuk bilang "tidak ada" — kombinasi itulah yang membuat WeVisOne-VL layak diperhatikan.